
重建缓存那几分钟:目录站的缓存击穿、雪崩和三条止血手段
 重
缓存用久了会形成一种错觉:反正有缓存扛着,数据库慢一点没关系。直到某天一个热点 key 过期,几千个请求同时绕过去直奔数据库,前端瞬间全白。
目录站在这件事上比一般站点更危险,因为热点太集中——首页和几个大分类页就占了大部分流量,这几个页面的缓存一旦同时出问题,整站跟着瘫。
图片来源:网络,版权归原作者所有,侵权请联系删除
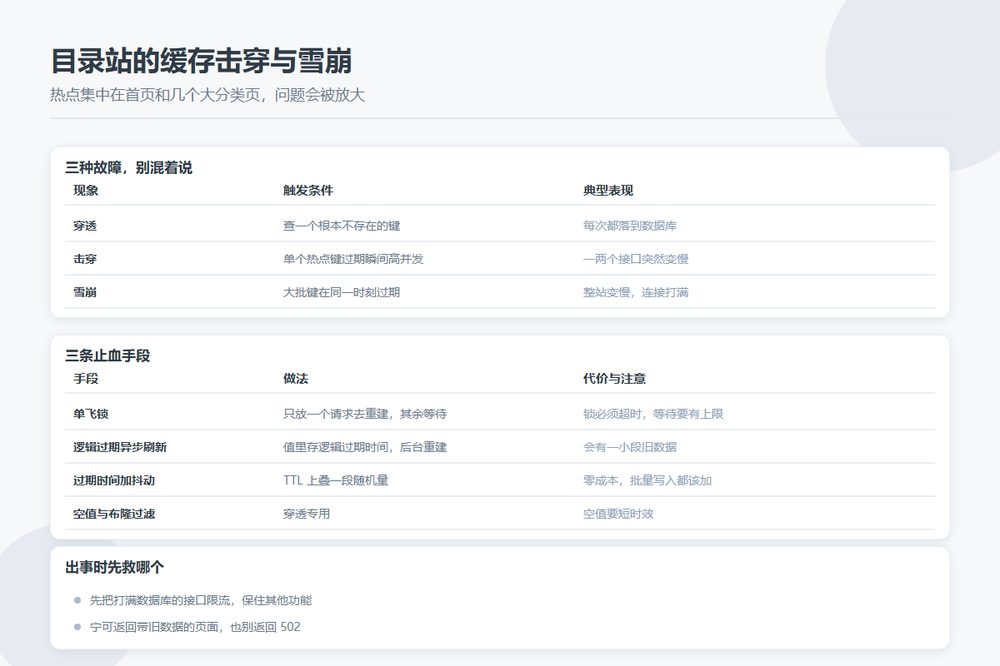
三种故障,别混着说
| 现象 | 触发条件 | 典型表现 |
|---|---|---|
| 穿透 | 查一个根本不存在的键 | 每次都落到数据库,缓存形同虚设 |
| 击穿 | 单个热点键过期瞬间高并发 | 一两个接口突然变慢,其余正常 |
| 雪崩 | 大批键在同一时刻过期 | 整站变慢,数据库连接打满 |
三种的修法不一样,先判断是哪一种再动手。看监控能分辨:只有一两个接口抖是击穿,全站一起抖是雪崩,某个不存在的 ID 被反复查是穿透。
第一条:单飞锁
热点键过期时,不让所有请求都去重建,只放一个进去,其余的等着拿结果。实现上就是在重建前抢一把锁,抢到的去查数据库写缓存,没抢到的短暂等待后重读缓存。
两个细节要处理好:锁必须有超时,不然拿到锁的进程挂了,后面全堵死;等待要有上限,超过就直接返回,别让请求无限排队。
单飞锁对付击穿很有效,但要注意它把压力从数据库转移到了锁本身的等待队列上,超时时间设太长会在高峰期堆积大量挂起请求。
第二条:逻辑过期加异步刷新
换一种思路——缓存里的数据不设物理过期,而是在值里存一个逻辑过期时间。请求拿到的永远是旧数据,但发现逻辑过期后,后台异步触发一次重建。
好处是请求永远不用等,代价是用户会看到一小段时间的旧数据。对目录站来说这个代价可以接受:条目信息晚几分钟更新没人看得出来。但涉及状态的内容不能用这招,比如「已下架」这种标记,显示旧值会出事。
第三条:过期时间加抖动
雪崩的根源是大量键在同一时刻过期,而它们往往是同一次发布或同一批预热写进去的。解决办法极其简单:给过期时间加一段随机量。
比如基础 TTL 设三十分钟,实际写入时在 30 到 40 分钟之间随机取。一批键的过期时间就散开了,不会再出现同一秒集体失效。这一条几乎零成本,值得在所有批量写入的缓存上默认加上。
穿透则靠另外两招:查不到的键也写一个短时效的空值进去,避免反复查;量大的话在前面加一层布隆过滤器,先判断这个键可不可能存在。
出事时先救哪个
真到了雪崩那几分钟,顺序别乱:先把数据库连满的那个接口限流,保住其他功能;再把最热的几个页面用静态兜底顶上;最后才是修根因。别一边救火一边改代码上线,那只会让情况更复杂。
还有一件容易被忘的事:连续返回 5xx 会让搜索引擎主动降低抓取频率,恢复起来要几天。扛不住的时候宁可返回一个带旧数据的页面,也别返回 502——但页面上要说清楚这是缓存内容,别让用户以为看到的是最新的。
事后补一件事:给缓存命中率和回源量加告警。命中率突然掉一截,往往就是雪崩的前兆,那时候改还来得及。