
按热度排序那个链接该不该让搜索引擎抓:目录站列表页的排序参数和展示状态该怎么留
 按
目录站的列表页天生带一堆可选项:按时间、按热度、按评分,列表或宫格,每页 20 条或 50 条。这些选项每多一个,URL 就多一重组合。我翻过自己站的日志,一个只有 240 个条目的分类,被蜘蛛抓过的地址里有七八十个是同一批内容的不同排列。
图片来源:网络,版权归原作者所有,侵权请联系删除
先定正主:默认排序 + 无参数地址
处理参数问题的第一步不是屏蔽,是选出一个正主地址。正主就是那个不带任何参数的分类页 URL,用默认排序(通常是编辑排序或最新收录),其余全部是它的变体。
这么做的好处是规则简单。爬虫第一次碰到这个分类页时读到的就是标准形态,不需要先理解参数再去找 canonical。用户在浏览器地址栏复制出来的链接也是最干净的那个。
默认排序本身该怎么选,判断标准是「这个排列对用户有没有独立价值」。按热度排出来的顺序是有信息量的,值得保留成可访问状态;按评分排、按字母排,在条目量不到几百的类目里往往只是换个顺序,价值有限。
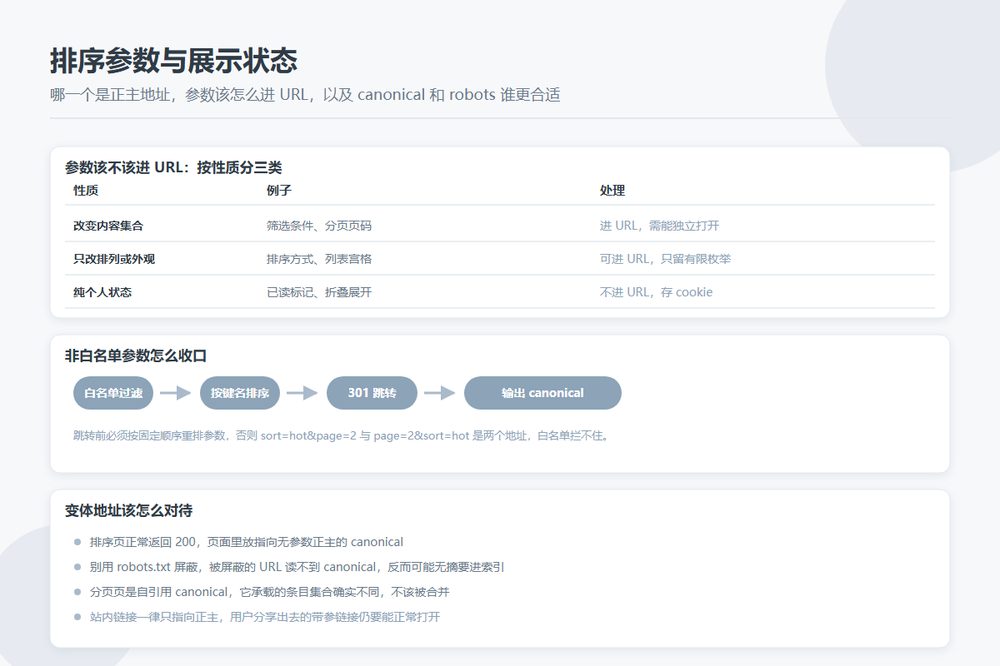
参数该不该进 URL:按性质分两类
| 性质 | 例子 | 处理 |
|---|---|---|
| 改变内容集合 | 筛选条件、分页页码 | 进 URL,需要能独立打开 |
| 只改变排列或外观 | 排序方式、列表/宫格、每页条数 | 可进 URL,但只留有限枚举值 |
| 纯个人状态 | 已读标记、折叠展开、主题配色 | 不进 URL,存 cookie 或 localStorage |
第三类最容易被误放进 URL。我见过有站把「是否展开筛选面板」写进了 query,结果爬虫每抓一次就多一个新地址。这类状态的共同点是换个人打开就不一样,它不属于页面内容。
第二类要收口。排序方式只允许 sort=new|hot|rating 三个值,传进来的其他值一律 301 到默认排序,而不是原样渲染。视图切换(列表/宫格)建议干脆不进 URL,用 cookie 记住,因为它对内容没有任何影响。
canonical 和 robots 在这里谁更合适
答案是 canonical,而且别用 robots.txt 去屏蔽这些参数地址。
原因不是 preference,是机制。被 robots.txt 屏蔽的 URL,爬虫读不到它上面的 canonical,但它可能因为外链或站内链接被发现,最后以一个没有摘要的形态进索引。想让爬虫知道「这只是个变体」,就得让它能读到这个页面上的 canonical 标签。
所以排序页的正确配置是:正常返回 200,页面里放自引用之外的规范链接,指向无参数的正主地址。分页页则是指向自己(分页自引用 canonical),因为它承载的条目集合确实不一样,不该被合并掉。这两条规则同时存在并不冲突:变体合并到正主,分页各自独立。
谷歌那套网址参数处理工具早在 2022 年就下线了,现在这件事只能在自己站点这层解决。好消息是也只需要一层:模板里统一输出 canonical 就行。
非白名单参数怎么收口
光靠 canonical 只能解决「爬虫读到了之后怎么理解」,解决不了「变体太多」本身。所以还要有一道收口:服务端维护一份参数白名单。
请求进来时,先把参数按名字排序、拆成键值对,不在白名单里的直接丢弃,然后 301 跳转到规范化后的地址。这一步顺手还能干掉三种常见垃圾:别人外链时带的推广参数、被注入的随机串、追踪用的会话 ID。
实现上有个细节容易错:跳转前必须按固定顺序重排参数,否则 ?sort=hot&page=2 和 ?page=2&sort=hot 是两个地址,白名单拦不住。排序后它们变成同一个字符串,才能被正确归并。
分享出去的链接要能打开
有个矛盾要处理:用户点了「按热度排序」之后想把这个链接发给别人,希望对方打开还是热度排序。如果为了索引干净把所有排序态都剥掉,这个分享就失效了。
做法是区分入口。带排序参数的地址正常渲染、正常 200,只是带上指向正主的 canonical;站内链接一律只指向正主。这样用户分享的链接有效,爬虫也不会顺着站内链接爬出一堆变体。
至于那些只靠外部渠道传进来的变体地址,就让 canonical 去收拾。它们数量有限,形不成规模。
怎么确认收口生效了
看三个地方:Search Console 的网页索引报告里,参数地址有没有单独成条;服务器日志里带参数的请求占比有没有下降;站内搜索结果里有没有出现同一个分类页的多个排序版本。
参数治理做完之后,最直观的变化往往是抓取效率——同样是每天三千次抓取,原来有一半花在辨认变体上,现在这些配额能用在真正的条目页上。这对有几万个页面的目录站来说是实打实的差别。