
条目页那个相似站点模块:相似度到底该按什么算,三种做法各自的代价
 条
几乎每个目录站的条目页底部都有一块「相似站点」。但点进去看,一半以上是同分类里随机抽的几条,或者干脆是最新的几条。这不叫相似,这叫占位。
图片来源:网络,版权归原作者所有,侵权请联系删除
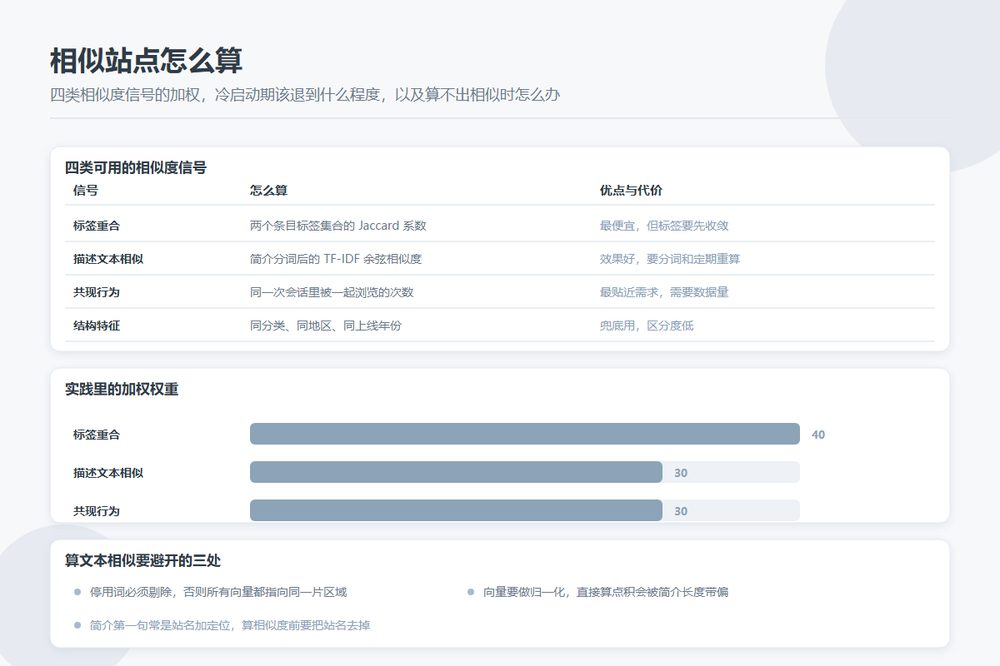
四类可用的相似度信号
| 信号 | 怎么算 | 优点 / 代价 |
|---|---|---|
| 标签重合 | 两个条目标签集合的 Jaccard 系数 | 最便宜,但标签本身要够规范 |
| 描述文本相似 | 简介分词后的 TF-IDF 余弦相似度 | 效果好,需要分词和定期重算 |
| 共现行为 | 同一次会话里被一起浏览过的次数 | 最贴近真实需求,需要数据量 |
| 结构特征 | 同分类、同地区、同上线年份等字段 | 兜底用,区分度低 |
实践里通常不是四选一,而是加权。我的经验权重是标签 0.4、文本 0.3、共现 0.3,结构特征只在三者都算不出结果时才启用。
标签那一项最容易做也最容易做坏。前提是标签体系本身收敛——同一类站点用的是同一批标签词。如果「在线设计」「在线设计工具」「设计工具」三个标签同时存在,Jaccard 算出来会趋近于零,标签维度等于废掉。所以做相似度之前,先把标签词典合并一遍。
文本相似要避开的三个坑
TF-IDF 那一路不复杂,用现成的分词加向量化就能跑,但有几个细节直接决定效果。
第一个是停用词。目录站的简介里高频出现的「提供」「支持」「可以」这些词没有任何区分度,必须剔除,否则所有站点的向量都会指向同一片区域。第二个是简介长度差异,一段 300 字的描述和一段 30 字的描述,向量模长差很多,一定要做归一化——余弦相似度本身有这一步,直接算点积的写法没有。第三个是同一个词被反复堆砌的营销简介,需要限制词频上限。
还有一点容易被忽略:算相似度之前要把简介里的站名去掉。不少目录站的简介第一句就是站名加定位,两句话一模一样会让相似度虚高。
冷启动期该退到什么程度
新条目没有共现数据,文本相似度也因为邻居太少而不稳定。这时候硬算出来的推荐,质量不如不做。
分三档处理:条目上线不到一周,推荐模块整体不展示,页面少一块不影响什么;一周到一个月,只用标签和结构特征,展示三条;一个月以上,四条信号全开,展示六条。
这个退让是有理由的。推荐模块的质量是会被用户感知的,前几次点进去发现全是乱推,这个模块就死了,之后做得再准也没人点。宁可上线时没有,也不要上线时很烂。
算不出「足够相似」的时候怎么办
会经常遇到。冷门类目里只有 12 个条目,任何一个的相似度都很低。这时候有两条路:展示相似度最高的那几条并如实标注「同类目其他站点」,或者干脆不展示这个模块。
我倾向于第一种,但标签要诚实。把「相似站点」换成「同类目站点」,用户预期就对上了。挂着一个名不副实的模块标题,比没有模块更伤信任。
阈值怎么定也有讲究。不要用固定阈值(比如相似度 > 0.3 才展示),因为不同类目的分布完全不一样。用相对阈值:取候选里最高的前 N 条,并要求最高分不低于一个很低的底线(比如 0.08)。这样热门类目和冷门类目都能有合理表现。
这个模块对内链和抓取的影响
相似站点是目录站里密度最高的内链来源。每个条目页出 6 条,一万条目就是六万条链接,而且都是详情页指向详情页的深层链接。
好处是深层条目有了稳定的内链来源,不用靠分类页翻很多页才能被抓到。坏处是如果相似度算得不好,这些链接是随机噪声,白白消耗抓取预算。
控制办法两条:一是限制每个条目出链数量,六条足够,不要做「查看更多」无限加载;二是链接必须是服务端渲染的真 <a> 标签,锚文本用站名而不是「点击查看」。用 JS 动态插入的推荐列表,爬行时读到的可能只是个空容器。
多久重算一次
文本和标签相似度可以离线批量算,写入一张结果表,条目新增或简介变更时增量更新,全量重算一周一次就够。共现数据按天更新,取最近 30 天的滑动窗口。
别把相似度计算放在页面渲染时同步执行。每条查询都要扫一遍全表向量,页面响应时间会直接崩掉。这是个典型的「看起来不重,实际很重」的计算,必须离线化。