
让模型给条目自动归类和打标签:能自动到什么程度,哪些必须留给人
 让
先把两件事分开说:归类和生成。归类是选择题,候选类目是固定的那几十个;生成是填空题,输出什么都有可能。这两件事的可控性差着一个量级——选择题错了能一眼看出来,填空题错了可能整段读着都顺。
所以让模型做归类,本身是个合理的想法。前提是把它设计成选择题。
图片来源:网络,版权归原作者所有,侵权请联系删除
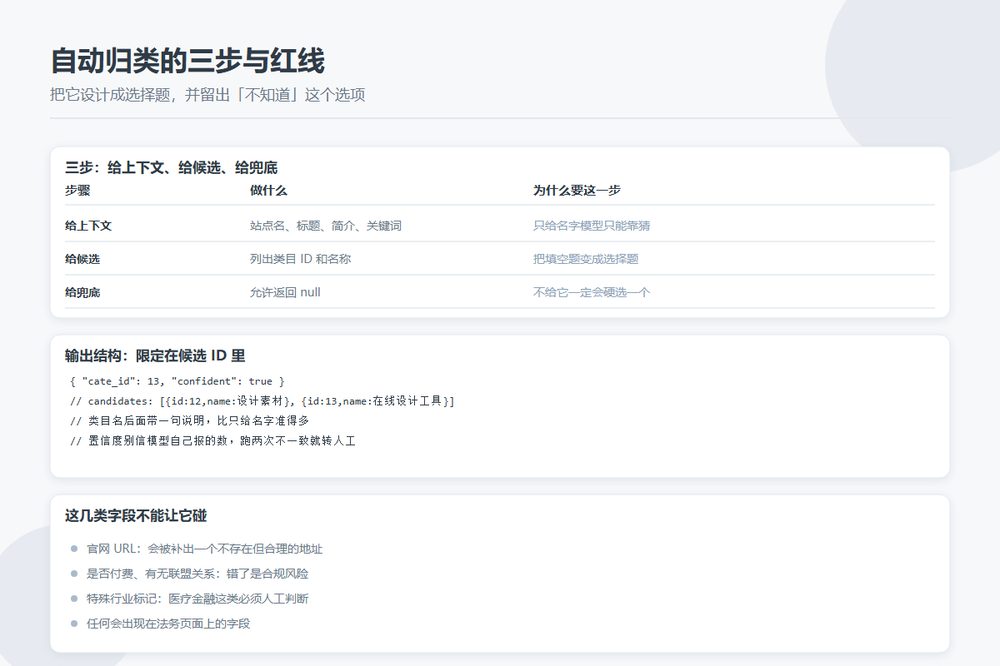
三步:给上下文、给候选、给兜底
| 步骤 | 做什么 | 为什么要这一步 |
|---|---|---|
| 给上下文 | 站点名、官网标题、简介、几个关键词 | 只给名字,模型只能靠猜 |
| 给候选 | 把类目 ID 和名称列全,要求只能从中选 | 把填空题变成选择题 |
| 给兜底 | 允许返回 null,表示「都不合适」 | 不给兜底它一定会硬选一个 |
第三条最容易被忽略。你不给它「不知道」这个选项,它就永远不会说不知道,只会从候选里挑一个最像的。宁可让它返回 null 转人工,也不要让一个明显不合适的类目被静默填上。
{
  "site_name": "...",
  "homepage_title": "...",
  "description": "...",
  "candidates": [
    {"id": 12, "name": "设计素材", "desc": "图片、字体、模板等资源"},
    {"id": 13, "name": "在线设计工具", "desc": "可直接在浏览器里出图的工具"}
  ],
  "output": {"cate_id": 13, "confident": true}
}
候选里带上一句类目说明,效果比只给名字好很多。「设计素材」和「在线设计工具」这两个名字,人和模型都容易混。
置信度别信模型自己报的那个数
很多人会让模型顺带输出一个 0 到 1 的 confidence,然后按阈值过滤。这个数的参考价值有限——它反映的是模型对自己输出的「语气强度」,不是真实准确率,而且不同模型的标定差得很远。
更可靠的办法有两种。一种是同一条跑两次(换温度或者换提示词顺序),两次结果不一致就转人工,这个成本很低但很有效。另一种是双轨校验:先用关键词规则跑一遍,只有模型结果和规则结果一致时才自动采纳,不一致就转人工。后者的自动采纳率会低一些,但漏出来的错也少。
这几类字段不能让它碰
- 官网 URL。模型会「补全」出一个看起来合理但不存在的地址。这类字段只能来自抓取或人工填写,且必须验证可达。
- 是否付费、有没有联盟关系。这关系到合规标注,错了是实打实的风险,不是分类放错位置那种小错。
- 特殊行业标记。医疗、金融这类需要人工判断准入的,自动打个标签然后放出去,后果比慢几天严重得多。
- 任何会出现在法务相关页面上的字段。模型输出的措辞没法承担法律责任。
一句话概括:影响展示的字段可以自动,影响合规和资金的字段必须人工。
抽样核对怎么抽
全量人工核对就没意义了,抽样要注意两点。一是分层,别均匀随机抽——新类目、边界类目(就是那几个容易混的)要多抽,成熟稳定的类目可以少抽。二是整批回退机制,某个类目这一批的错误率超过阈值(比如 5%),就把这一批全部退回人工,而不是只改抽出来的那几条。模型的错误是有规律的,抽出来的错误往往只暴露了其中一类。
留痕也一样重要:谁改的、什么时候、从什么改到什么。这条记录不只是为了追责,更是为了下次调提示词时有数据可看。
和搜索引擎的关系
有人担心「用了模型,会不会被判定为 AI 生成内容」。这里要分清楚:搜索引擎针对的是为了排名而批量生产的页面内容。自动归类、自动打标签处理的是结构化字段,不产生新的页面文字,性质完全不同。
真正会踩线的是后半步:如果类目页或者条目简介也交给模型批量写,几千个页面一套模板换词,那才是政策里说的规模化内容滥用。工具本身不是问题,拿它干什么才是。
一个顺手的判断标准:把这条内容的用户换成真人编辑,如果他写出来会被用户投诉「这写的什么」,那模型写的也一样会被投诉。