
两条条目到底算不算重复:编辑距离、SimHash、MinHash 和向量相似度,目录站该挑哪个
 两
目录站的去重通常分两道:第一道是域名归一化,把协议、www、末尾斜杠、大小写这些变体统一,再按主域名判重,这一步能挡掉绝大多数重复提交。真正麻烦的是剩下来的——同一个人用不同的邮箱提交了同一家公司的两个子站,或者同一个工具被换了名字再交一遍。
这类情况要靠相似度。但「相似度」是个很含糊的说法,得先想清楚你比的是什么。
图片来源:网络,版权归原作者所有,侵权请联系删除
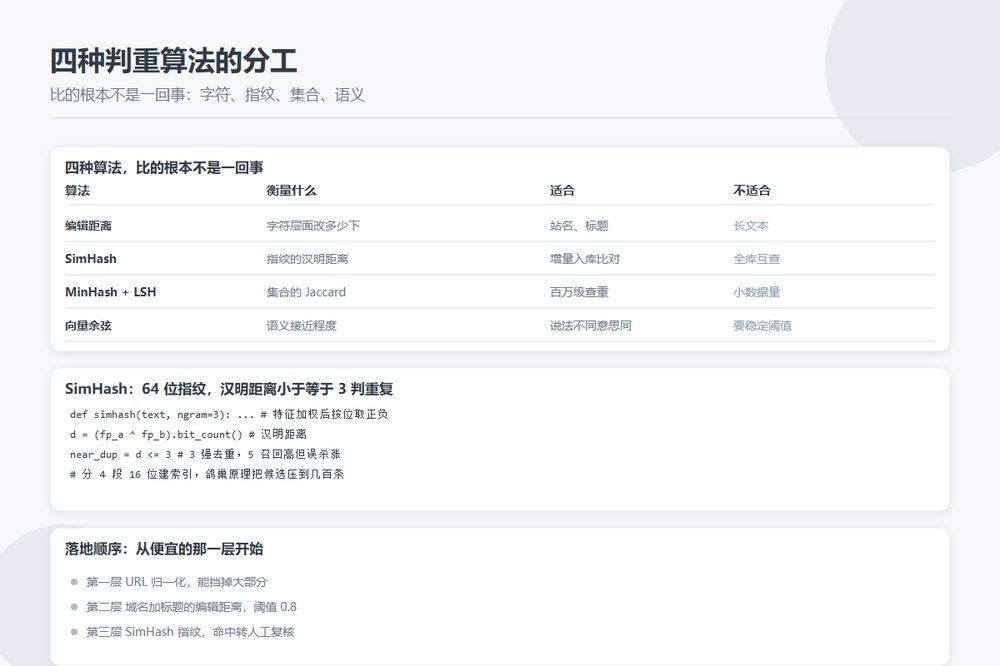
四种算法,比的根本不是一回事
| 算法 | 衡量什么 | 适合 | 不适合 |
|---|---|---|---|
| 编辑距离 / difflib | 字符层面要改多少下 | 短文本、站名、标题 | 长文本,复杂度太高 |
| SimHash | 64 位指纹的汉明距离 | 增量入库时跟已有库比 | 需要找出所有相似对 |
| MinHash + LSH | 集合的 Jaccard 重合度 | 百万级两两查重 | 小数据量,杀鸡用牛刀 |
| 向量余弦 | 语义层面的接近程度 | 说法不同但意思相同 | 要稳定阈值、要可解释 |
编辑距离:短文本够用,也是最直观的
站名、标题这种几十个字符的字段,用编辑距离或者 Python 标准库里的 difflib.SequenceMatcher 就够了。它算的是把一个字符串改成另一个需要多少次插入删除替换,再用 ratio 归一化到 0 到 1。
from difflib import SequenceMatcher

def norm(s):
    return re.sub(r'[^a-z0-9\u4e00-\u9fff]', '', s.lower())

def same(a, b, th=0.8):
    return SequenceMatcher(None, norm(a), norm(b)).ratio() >= th
阈值取 0.8 是个经验起点,不是定律。站名里带「官网」「官方网站」这类后缀的情况要先剥掉再比,不然两个同样的站会因为一个有后缀一个没有而判不出来。它的复杂度是长度乘积级别,长简介别用它。
SimHash:给每条条目算一个指纹
SimHash 是 Charikar 在 2002 年提出的方法:把文本切成特征(通常是词或 n-gram),每个特征哈希成 64 位,按位加权累加(该位为 1 就加权重,为 0 就减权重),最后看每一位的正负决定指纹的这一位是 0 还是 1。相似文本的指纹,汉明距离会很近。
谷歌爬虫团队在 2007 年的论文里给出的经验是:64 位指纹下,汉明距离小于等于 3 可以判为近似重复。这是从网页语料上跑出来的数,换到自己的库上要重新调——一般 3 是强去重,放到 5 召回更高但误杀也跟着涨,6 到 10 之间通常只能说明「主题相近」,不能当重复处理。
它最大的工程价值是查询可以做得很快:把 64 位切成 4 段 16 位,按鸽巢原理,汉明距离不超过 3 的两个指纹,至少有一段 16 位完全相同。给四段各建一个索引,查询时只比候选桶里的几百条,不用跟全库做异或。
d = (fp_a ^ fp_b).bit_count()   # Python 3.8 用 bin(x).count("1")
near_dup = d <= 3
中文没有空格,分词结果直接决定指纹质量。不做分词、直接用字符 n-gram(比如 3-gram)也能跑,特征更密,阈值可以稍微放宽。
MinHash 加 LSH:要在百万级里互相找重复时才值得上
SimHash 给的是一个距离函数,适合「新来一条,跟已有库比一下」。但如果你要做的是「把现有两百万条互相比一遍,找出所有相似对」,SimHash 也是两两比较,一样是平方级。
MinHash(Broder 1997)估的是 Jaccard 相似度,也就是两个 shingle 集合的交集除以并集。做法是用 k 个哈希函数各取集合里的最小值,两个文档在同一个哈希函数下取到相同最小值的概率,恰好等于它们的 Jaccard 相似度。k 取 128 时标准误大约是 1/√128,接近 9%;k 越大越准,代价是签名越大。
真正让它变快的是 LSH 分带:把签名切成 b 个带、每带 r 行,只有某一带完全撞上的才算候选对。阈值大致是 (1/b) 的 (1/r) 次方,调 b 和 r 就能把那条 S 曲线挪到你要的位置。这之后就不用两两比了。
向量相似度:能抓语义,代价也最高
「在线设计工具」和「网页设计工具」在字符层面差得远,SimHash 抓不到,词向量能抓到。但代价是三条:要额外跑一次嵌入、阈值不稳定(不同类目合适的阈值不一样)、结果不可解释(你没法指着一段话说「就是这里重复了」)。
我的建议是把它当召回层用,不当判定层用:向量找出候选,再用编辑距离或人工确认一遍。
目录站的实际落地顺序
- 第一层,URL 归一化。免费、确定、能挡掉大部分。
- 第二层,域名加标题的编辑距离。阈值 0.8,处理归一化之后的残留。
- 第三层,SimHash 全量指纹。新条目入库时查一次,汉明距离 ≤3 转人工。
- 第四层,人工复核队列。把前三层命中的排在一起给人看,一次能处理几十条。
到了几十万条、需要全库互查的时候,再考虑 MinHash 加 LSH。别一开始就上最重的方案——绝大多数目录站的重复问题,前两层就解决完了。
最后一句:不管用哪套算法,合并条目时都要留痕,记下谁在什么时候把哪条并到了哪条。判重会出错,能回滚比判得准更重要。