
Web、H5、小程序、App:目录站多端的收录分工该怎么划
 W
做目录站做到一定规模,多端几乎是必然:网页版承接搜索流量,小程序承接微信内的分享和搜一搜,App 留给高频用户。麻烦在于,各端的收录规则完全不同,套用同一套思路会踩坑。
图片来源:网络,版权归原作者所有,侵权请联系删除
先把各端的流量来源摆清楚
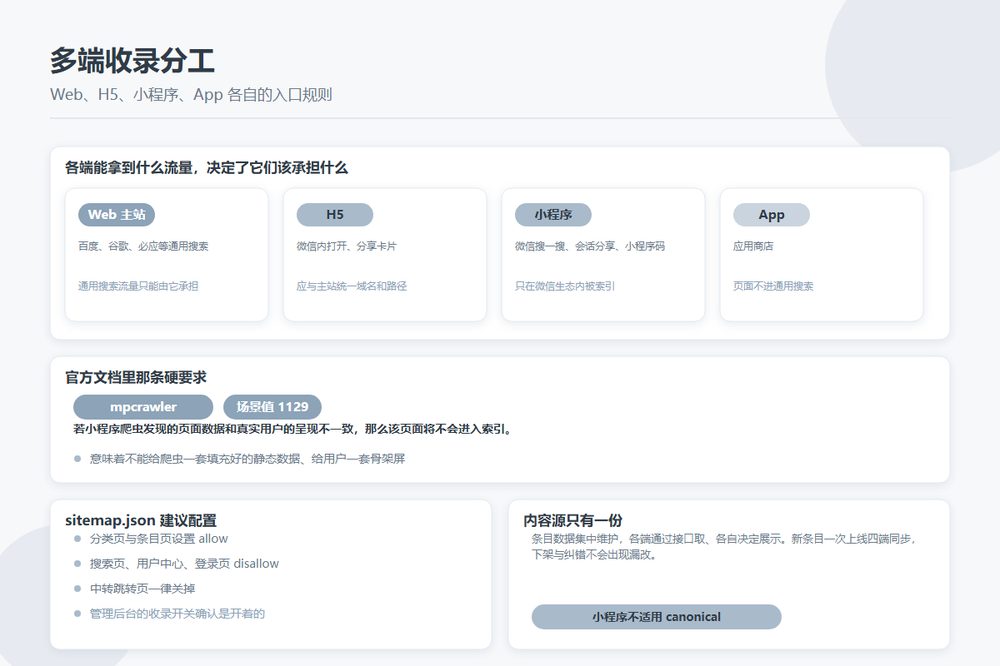
| 端 | 主要入口 | 能否被搜索引擎收录 |
|---|---|---|
| Web 主站 | 百度、谷歌、必应等通用搜索 | 能,主力 |
| H5 | 微信内打开、分享卡片 | 能,但应与主站统一 URL |
| 小程序 | 微信搜一搜、会话分享、小程序码 | 只在微信生态内 |
| App | 应用商店 | 页面不进通用搜索 |
看清这张表,分工就清楚了:通用搜索的流量只能由 Web 主站承担,小程序拿到的是微信生态内的流量,App 的页面基本不参与搜索。想让小程序给主站带搜索权重,方向就是错的。
小程序收录:官方文档里那条硬要求
小程序的收录由开发者自己控制,根目录的 sitemap.json 决定哪些页面允许被微信索引,管理后台还有一个总的页面收录开关。没有 sitemap.json 时,默认是所有页面都允许被索引。
官方文档里有两段话值得抄下来贴在工位上:
- 爬虫访问小程序页面时,会携带特定的 user-agent:
mpcrawler,场景值1129 - 若爬虫发现的页面数据和真实用户的呈现不一致,那么该页面不会进入索引
第二条是关键。它意味着小程序不能搞两套——给爬虫一套填充好的静态数据、给用户一套加载中的骨架屏,这条路是堵死的。页面必须在爬虫访问时就能呈现出和真实用户一样的内容。
对目录站来说这条尤其要命。条目列表如果是异步加载、且首屏对爬虫返回空,那这些页面就不会进索引。做法上要么服务端直出首屏数据,要么保证爬虫能拿到渲染后的完整内容。
sitemap.json 怎么写
规则是一个数组,按顺序匹配,每条有 action(allow 或 disallow)、page(页面路径)、params(参数名列表)、matching(匹配方式)几个字段。三种典型配置:
- 全站开放:
{"action":"allow","page":"*"} - 只开放某几类页面:先 allow 具体路径,再 disallow 全部
- 给带特定参数的页面优先索引:用 params 加 matching 指定
目录站建议的配置是:分类页和条目页开放,搜索页、用户中心、登录页、中转跳转页全部关掉。这几类关掉之后,索引质量会好很多。
另外有个容易忽略的设置:管理后台的收录开关如果关了,首页以外的页面都不会被抓取。很多站是默认关着却不知道。
内容源只有一份,端只是壳
多端最容易烂掉的原因是一份内容四份维护。正确做法是条目数据只有一份,各端通过接口取,各自决定怎么展示。
这样做有三个直接好处:新条目上线一次四端同步;条目的下架、纠错不会出现"网页版改了小程序没改";统计口径统一,看得出一个条目在所有端的总表现。
URL 层面要注意:H5 应该直接用主站的域名和路径,不要单独搞一个 h5 子域。小程序没有传统意义的 URL,不需要也不适用 canonical——它和主站在两个生态里,不存在重复内容问题,别硬套。
各端该盯的指标不一样
- Web:收录量、展现量、点击率、抓取异常
- 小程序:搜一搜带来的打开次数、分享回流率、页面被索引的比例
- App:日活、次日留存,跟 SEO 指标分开看
把三端的数据混在一张表里看,最容易得出的错误结论是"小程序没用"——它本来就不承担通用搜索流量。
多端不是多份内容,是同一份内容的多个出口。把内容源收拢到一处,各端只负责展示和承接,维护成本和维护质量都会立刻改善。