
搜索框里那个下拉:目录站联想词接口的收录风险怎么控
 搜
用户在搜索框里敲两个字,下面跟着冒出五个候选词,这个交互几乎已经是标配。实现上通常是一个异步接口,比如请求一个 suggest 地址,带回一批候选。
图片来源:网络,版权归原作者所有,侵权请联系删除
风险不是来自接口,是来自接口后面的页面
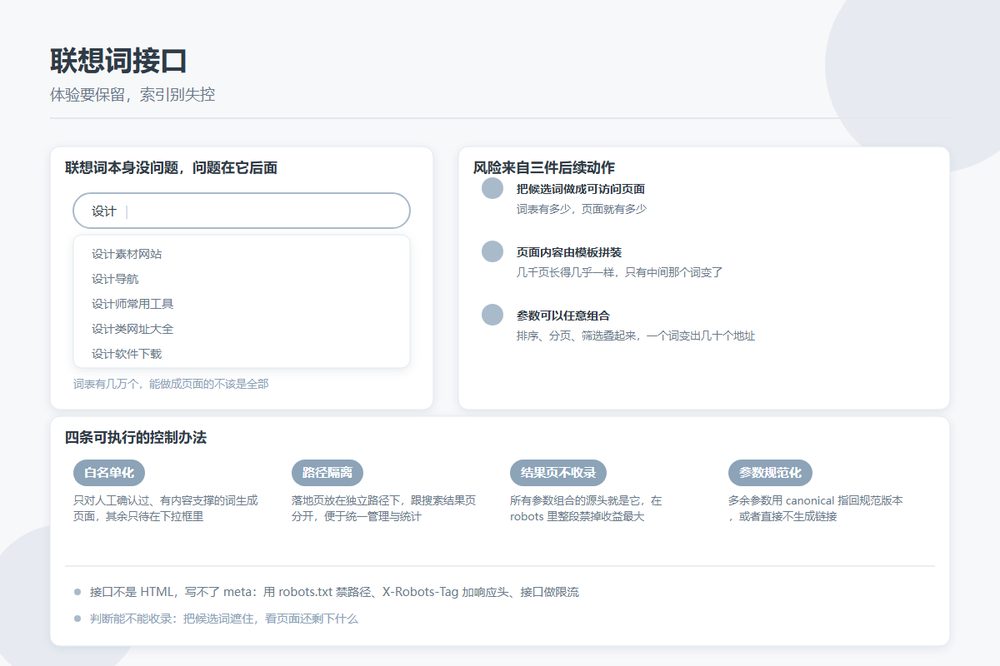
接口本身返回的一般是 JSON,搜索引擎抓到了也不会当页面收录,这一层问题不大。真正出事的是三种后续动作。
- 把联想词做成了可访问的页面。比如给每个候选词生成一个地址,点进去是一个"相关结果"页。词表有多少,页面就有多少
- 页面内容由模板拼装。几千个页面长得几乎一样,只有中间那个词变了,典型的低质量批量页
- 参数可以任意组合。加上排序、分页、筛选之后,同一个词能变出几十个地址,都能访问、都能被抓
这三件事叠起来,一个月之内索引量翻几倍是很常见的。而索引膨胀的代价不是显式的惩罚,是抓取预算被稀释——真正重要的分类页和条目页被爬得少了。
接口不是 HTML,meta 标签管不到它
很多人的第一反应是给联想词页加 noindex。如果这个页面真的存在,加 noindex 是对的;但接口返回的 JSON 根本没有 head,加不进去。
对接口本身,能用的是另外两个手段:
| 手段 | 作用 | 注意 |
|---|---|---|
| robots.txt 禁止该路径 | 拦住守规矩的爬虫 | 对不守规矩的无效,但能避免浪费抓取 |
| X-Robots-Tag 响应头 | 给非 HTML 响应加指令 | 要在服务端配,配错会影响同路径其他资源 |
| 接口鉴权或限流 | 异常高频请求直接拒 | 注意别把搜索引擎的正常请求挡了 |
三者里最值得做的是第一个——robots 里把这个路径禁掉,成本几乎为零,能把绝大多数合规爬虫的无效抓取省下来。
要不要把联想词做成落地页
可以,但有个前提:这个页面得有接口之外的真实内容。
判断方法很简单——把候选词遮住,看页面剩下什么。如果剩下的只有一列链接、一段模板话术,那这个页面没有独立存在的价值,别放出来收录。如果剩下的是这个词的释义、相关的分类入口、精选的条目、更新的时间,那它是个正经页面。
能做收录的联想词页,是"这个词值得单独讲一页"的那一批,通常是几十到几百个;词表里那几万个长尾,只配待在下拉框里。
四条可执行的控制办法
- 白名单化。只对人工确认过、有内容支撑的词生成页面,其余只在下拉里出现,点击走正常的搜索结果页
- 路径隔离。联想词落地页放在独立路径下(比如 /topic/),跟搜索结果页 /search 分开,方便统一管理和统计
- 搜索结果页别收录。这一层是所有参数组合的源头,把 /search 整段在 robots 里禁掉,收益最大
- 参数规范化。排序、分页这些参数只保留必要的,多余的用 canonical 指回规范版本,或者直接不生成链接
顺带把性能和成本也解决了
联想词接口有个特点:请求量大、命中集中。热门的那几百个词会占掉绝大多数请求,加一层缓存能砍掉大部分数据库查询。同时给接口设频率上限,同一个来源短时间内的高频请求直接返回空结果——既是成本控制,也顺带挡掉了粗暴的抓取。
统计上也要分开看。联想词的点击率应该在站内搜索的分析里单独列一项,它反映的是词表质量,跟搜索结果页的零结果率是两个指标,混在一起看会误判。
联想词该做,但它的边界就到下拉框为止。把它当成批量生成页面的素材库,是目录站里性价比最差的一种扩张方式。