
等 Search Console 发邮件就晚了:目录站的自动化监控该盯哪几项
 等
月度巡检解决的是"慢慢变差"的问题,自动化监控解决的是"突然坏掉"的问题。两者不冲突,但很多站只有前者。
图片来源:网络,版权归原作者所有,侵权请联系删除
四类该自动盯的东西
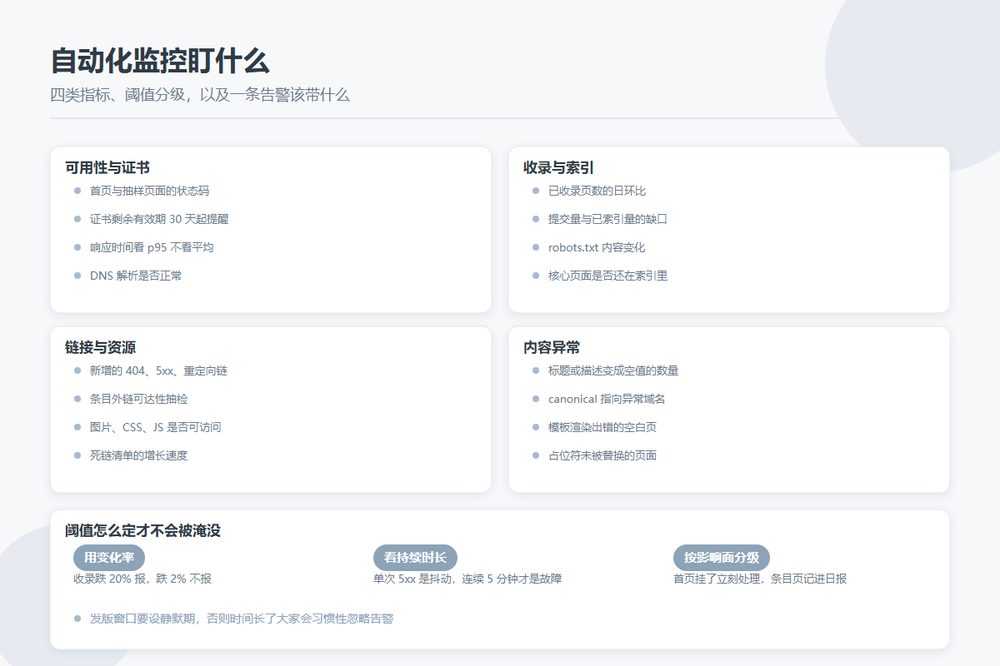
一、可用性与证书
- 首页、随机抽样的分类页和条目页的 HTTP 状态码,非 200 就告警
- 证书剩余有效期,低于 30 天开始提醒,低于 7 天升级
- 响应时间,用 p95 而不是平均值,超过基线一定比例就报
- DNS 解析是否正常,尤其是改动解析记录之后
证书过期是最常见也最冤的故障——完全可预期,却总有人中招。它只要一个定时任务就能覆盖。
二、收录与索引
- 已收录页数的日环比,跌幅超过阈值告警
- sitemap 提交量与平台报告的已索引量之间的缺口变化
- robots.txt 的内容变化(这个文件被误改的后果是整站级别的)
- 首页和核心分类页是否还在索引里
这一类的关键不是绝对值,是变化率。收录量慢慢涨或慢慢跌都正常,一天掉两成一定有事。
三、链接与资源
- 新增的 404、5xx、重定向链
- 条目外链的可达性抽检(目录站的核心资产就是这些链接的有效性)
- 页面上的图片、CSS、JS 是否可访问
四、内容异常
- 页面标题或描述变成空值的数量
- canonical 指向异常域名
- 模板渲染出错导致的空白页、占位符未替换
第四类常被忽略。目录站的页面由模板批量生成,一个模板改动的影响面是几千个页面,靠人工抽查基本抓不住。
阈值怎么定才不会被淹没
告警系统的失败方式通常不是不报,是报太多最后没人看。三条经验:
用变化率而不是绝对值;用持续时长而不是单次触发;按影响面分级而不是一视同仁。
- 变化率:收录量跌 20% 报,跌 2% 不报
- 持续时长:单次 5xx 可能是抖动,连续 5 分钟才是故障
- 影响面:首页挂了立刻打电话,某个条目页挂了记进日报
另外要给维护窗口留口子。发版期间必然有 5xx,如果不在监控系统里设置静默期,时间长了大家就习惯性忽略告警了。
一条合格的告警要带什么
"网站异常"这四个字是最没用的告警内容。收到的人还要花十分钟去查是什么异常。一条告警至少应该包含:
- 出了什么问题(具体的状态码、具体的指标)
- 影响范围(哪个路径、多少个页面)
- 什么时候开始的、持续多久了
- 可能相关的近期变更(发版记录里最近一次改动)
- 先看哪里(指向对应的日志或面板)
做到这个程度,值班的人不用查就能判断要不要立刻处理。
三个数据来源怎么搭
| 来源 | 覆盖 | 成本 |
|---|---|---|
| 外部拨测 | 可用性、证书、响应时间 | 低,现成服务很多 |
| 平台 API | 收录、抓取、索引状态 | 中,要写对接 |
| 服务器日志 | 请求、状态码、爬虫行为 | 中,需要日志分析 |
三者是互补的。平台数据有延迟但权威,日志实时但要自己判读,拨测反映外部视角。目录站建议至少把拨测和日志跑起来,平台 API 可以后补。
每季度做一次演练
监控搭完不等于能用。建议每个季度挑一个非高峰时段,人为制造一次故障——比如临时把某个分类页改成 500——看告警多久到、内容是否清楚、谁接收到了。没做过演练的监控系统,真出事时大概率会掉链子。
还要检查一遍:告警渠道还通不通、接收人有没有变动、阈值是不是早就该调整了。这些都会随时间腐化。
监控的价值不在发现问题的瞬间,在于把"用户先发现"变成"你先发现"。对页面动辄上万的目录站,这个时间差就是全部。