
页面缓存提速之后,目录站的收录开始串味:三种要盯的情况
 页
为什么要单独聊这件事
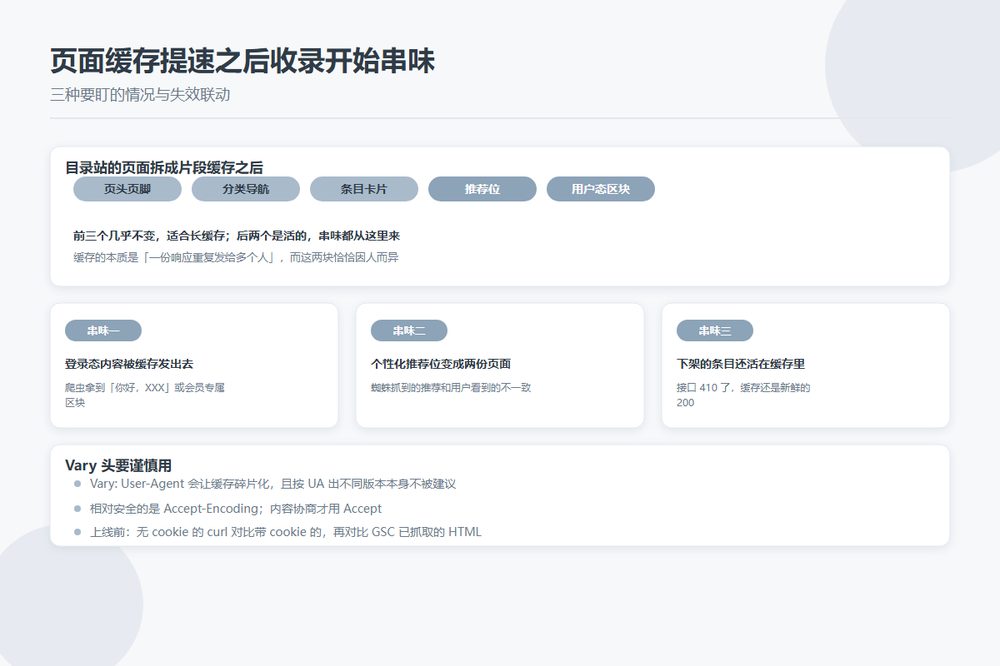
目录站的结构特别适合作片段缓存:页头页脚几乎不变,分类导航一天更新一次,条目卡片可以按条目粒度缓存,只有推荐位和用户态区块是活的。这么拆下来,动态渲染的占比能压到很低,TTFB 从几百毫秒掉到几十毫秒。
问题也随之而来。缓存的本质是「把一份响应重复发给多个人」,而你的页面里恰恰有几块是针对不同的人不同的。一旦这两件事撞上,就会出现爬虫看到的版本和用户看到的版本不一致的情况。
图片来源:网络,版权归原作者所有,侵权请联系删除
串味一:登录态内容被当成公共内容发出去
最典型的是页头那句「你好,XXX」或者会员专属入口。如果整页缓存的键里没有包含用户态,第一个访问者(很可能是爬虫)触发了缓存生成,之后所有人拿到的都是那份带他状态或完全无状态的 HTML。
对搜索引擎来说后果有两种,都不好:要么它抓到一份含私人信息的页面并可能展示出来;要么它抓到的是会员才能看的区块结构,误判页面内容。前者是隐私问题,后者是理解偏差。
做法上二选一:把用户态维度明确写进缓存键(代价是缓存命中率下降),或者干脆把页面拆成「公共骨架 + 用户态片段」,骨架走缓存,用户态片段用 ESI 或前端异步单独取。谷歌那边建议的是,给匿名访客和爬虫返回的那份内容,应当和用户无需登录就能看到的内容一致。
串味二:个性化推荐位把网页变成了两个人
目录站的推荐位常常按用户历史点击算。A 用户看过五个设计类条目,他的推荐位全是设计工具;蜘蛛来的时候没有任何历史,拿到的是默认推荐。
这本身不算作弊——个性化推荐是正常产品功能。但如果差异大到「爬虫看到的条目列表」和「用户实际看到的条目列表」几乎没有交集,就有点接近隐性变形了。更现实的坏处是:你以为被收录的推荐位能带来内链收益,实际上蜘蛛抓的那份里根本没那些链接。
稳妥的做法是:给无 cookie、无历史的请求返回一份稳定的默认推荐(比如按全站热度),并让这份默认推荐本身有内容价值。个性化版本作为增强,不作为唯一版本。个性化片段如果走异步请求,别让它承载需要被索引的内容。
串味三:下架的条目还活在缓存里
这条最伤。编辑在后台把某个违规条目下架了,接口返回 410,数据库里也删了,但 CDN 和页面片段缓存里还存着带这个条目的分类页 HTML,TTL 还有十分钟。
结果就是:用户已经看不到了,蜘蛛来抓的时候还能抓到,而且抓到的内容是新鲜的 200。如果这条涉及的投诉比较急,这十分钟可能就是你要解释的十分钟。
所以缓存失效必须和内容发布流程绑定,不能只靠 TTL 自然过期。
| 动作 | 要清什么 | 说明 |
|---|---|---|
| 条目下架 / 删除 | 该条目详情页 + 它出现的所有分类页、标签页、首页 | 按 tag 批量 purge 比逐个 URL 可靠 |
| 条目改名 / 换描述 | 详情页 + 列表页 | 列表页的锚文本跟着变,别漏 |
| 分类结构调整 | 受影响分类及父分类 | 面包屑变了,结构化数据也跟着变 |
| 全站模板改版 | 按前缀整体 purge | 不要指望 s-maxage 自然过期 |
Vary 头要谨慎用
Vary 告诉缓存「按这个请求头分别存版本」。听起来正好解决问题,实际用起来副作用不小。
Vary: User-Agent 是最典型的反例。UA 字符串变体成千上万,缓存会被切成无数碎片,命中率断崖下跌。更重要的是,按 UA 输出不同内容这件事本身就是谷歌不建议的——它推荐响应式设计,而不是给不同 UA 做不同版本。真要区分移动端,用 Vary 不如直接保证内容是同一份。
相对安全的是 Vary: Accept-Encoding(CDN 基本都会处理好)和 Vary: Accept(做内容协商时才用)。
上线前做一次对比
两件事,十分钟能做完:
- 用无 cookie 的 curl 抓一次页面,再用带登录 cookie 的抓一次,diff 一下,看无 cookie 版本里有没有混入不该出现的私人内容。
- 去 Search Console 的网址检查,点开「已抓取的 HTML」,和你浏览器里右键查看源代码的内容对比,看核心条目列表是不是同一份。
缓存是性能优化里见效最快的一步,也是最容易悄悄改变页面语义的一步。提速之后记得回头确认一遍:蜘蛛看到的,还是不是你想让它看到的那一页。