
服务器日志怎么读:从一条记录里看出蜘蛛到底爬了什么
 服
为什么不能只看 Search Console
谷歌自己的抓取统计报表有抽样、有加工,而且只统计它愿意告诉你的那部分。日志不一样,每一条都是一次真实请求,包括那些没被计入报表的、被 robots 挡掉的、返回 404 的、以及伪装成蜘蛛的那些。
对目录站来说,日志还有一个不可替代的价值:你能看到抓取在页面类型上是怎么分布的。几万个条目页和几千个参数化筛选页,谷歌把力气花在哪一边,只有日志能告诉你。
图片来源:网络,版权归原作者所有,侵权请联系删除
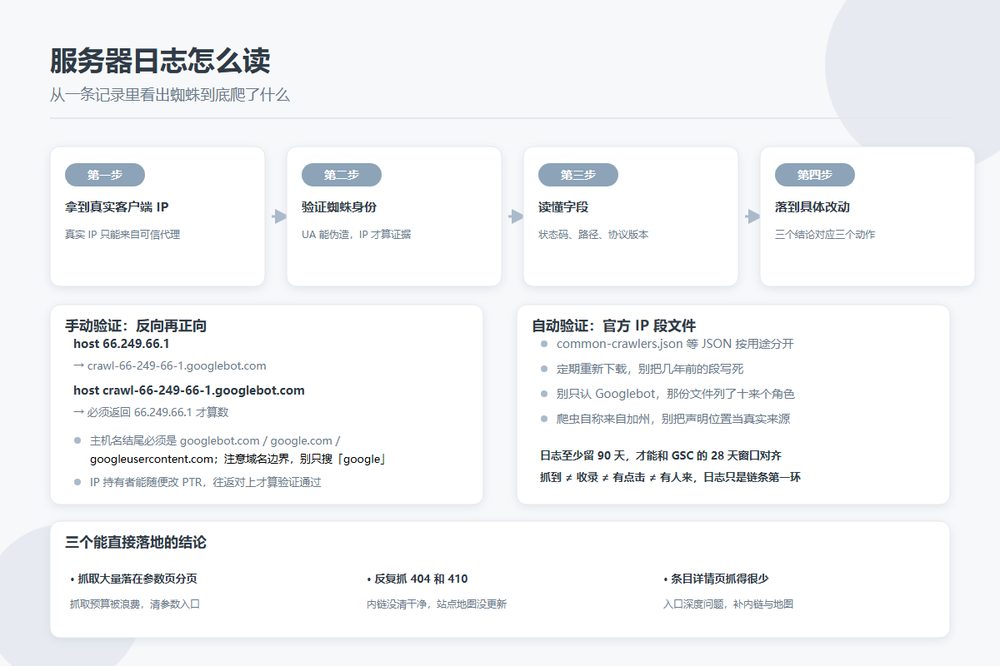
第一步:先确保拿到的是真实客户端 IP
站点如果挂在 CDN 或反向代理后面,日志第一列记的是代理的 IP,不是访客的。这一步没配好,后面全白做。
nginx 里配 real_ip_header 加 set_real_ip_from,把可信代理的网段列出来;Cloudflare 用 CF-Connecting-IP。关键是只信任你自己的代理——X-Forwarded-For 是访客可以自己伪造的一个头,直接拿来当真实 IP,等于把身份判断权交给了对方。
第二步:验证身份,UA 不算证据
任何人都可以在请求头里写 Googlebot。抓取工具、SEO 软件、扫描器都这么干,因为不少站点对 Googlebot 格外宽容。所以基于 UA 字符串做放行或封禁的规则,两头都会错:信了它,等于给爬虫开了后门;按它封,可能把真身一起封了。
谷歌文档给了两条路。
手动:反向再正向
host 66.249.66.1
# 返回 crawl-66-249-66-1.googlebot.com
host crawl-66-249-66-1.googlebot.com
# 必须返回 66.249.66.1
反向解析出来的主机名结尾必须是 googlebot.com、google.com 或 googleusercontent.com 三者之一。注意是域名边界,googlebot.com.example.net 不是 googlebot.com 的子域,只在字符串里搜「google」会误判。
第二步正向解析不能省。IP 的持有者可以随便改自己的 PTR 记录,只有反过去再正回来能对上,才算验证通过。
自动:匹配官方 IP 段
量大就用这个。谷歌以 JSON 形式发布了几份 IP 范围文件,按用途分开:common-crawlers.json(Googlebot 及其同类)、special-crawlers.json、user-triggered-fetchers.json、user-triggered-fetchers-google.json、user-triggered-agents.json。
两个注意事项:一是定期重新下载,地址段会变,把几年前的某段写死在配置里迟早出事;二是别只认 Googlebot,common crawlers 那份里列了十来个,Googlebot Image、Googlebot Video、Googlebot News、StoreBot、Google-InspectionTool、GoogleOther 等等,不同角色处理方式不一样,按「Google」一个词统一放行或统一拦截都是错的。
顺带一提,谷歌的爬虫自称来自加州,但它的数据中心是全球分布的。别把声明的地理位置当成实际来源去写规则。
第三步:读哪些字段
| 字段 | 能看出什么 |
|---|---|
| 状态码 | 200 / 301 / 404 / 410 / 5xx 各自占比,5xx 集中在某个时段说明服务器有问题 |
| 请求路径 | 抓取落在分类页、条目页、分页还是带参数的筛选页 |
| 协议版本 | 访问日志请求行里带 HTTP/1.1 或 HTTP/2.0,看蜘蛛实际用的哪一版 |
| 响应字节 | 突然变小可能是页面出错或者内容被抽空 |
| User-Agent(已验证的) | 区分桌面 Googlebot 和移动 Googlebot,移动优先索引下后者更重要 |
| 时间戳 | 抓取的时间分布,配合响应时间看高峰段有没有变慢 |
第四步:三个能直接落地的结论
- 抓取大量落在参数页和分页:说明抓取预算被浪费。把带 utm、排序、筛选参数的 URL 处理掉,或者至少别让它们出现在内链和站点地图里。
- 反复抓 404 和 410:说明站内还有指向它们的链接,或者站点地图没更新。蜘蛛会一直重试,纯浪费。
- 条目详情页抓得很少:通常是入口深度问题。条目只出现在分类页第 5 页往后,蜘蛛基本到不了。解法是加横向内链、相关条目推荐、以及站点地图覆盖。
两个提醒
第一,日志保留期至少要 90 天。Search Console 的效果数据是 28 天窗口,你要做同期对比,日志短了就对不上。压缩归档成本很低,没理由只留两周。
第二,也是最重要的一条:抓到不等于收录,收录不等于有点击,有点击不等于有人来。一条验证过的 200 记录只能证明蜘蛛取走了这一页。至于它有没有进索引、有没有出现在 AI 回答的引用里、有没有带来真实访问,是三段独立的证据,要分别去查。
把日志当成链条的第一环,而不是终点。它能告诉你蜘蛛来没来,至于来完之后发生了什么,得看别的地方。