
JS 渲染的目录页,搜索引擎到底能不能看到:动态渲染退场之后怎么选
 J
一个很典型的现场:前端同事做完新版导航首页,在浏览器里翻列表、点筛选,都很流畅。上线一个月,新加的几百个条目一个没被收录。查到最后发现,HTML 文档本体只有几 KB,内容全在接口返回里。
这件事到今天依然常见,只不过“搜索引擎看不懂 JS”这个说法已经过期了。现在的实际情况要复杂一点。
图片来源:网络,版权归原作者所有,侵权请联系删除
抓取是分两趟走的
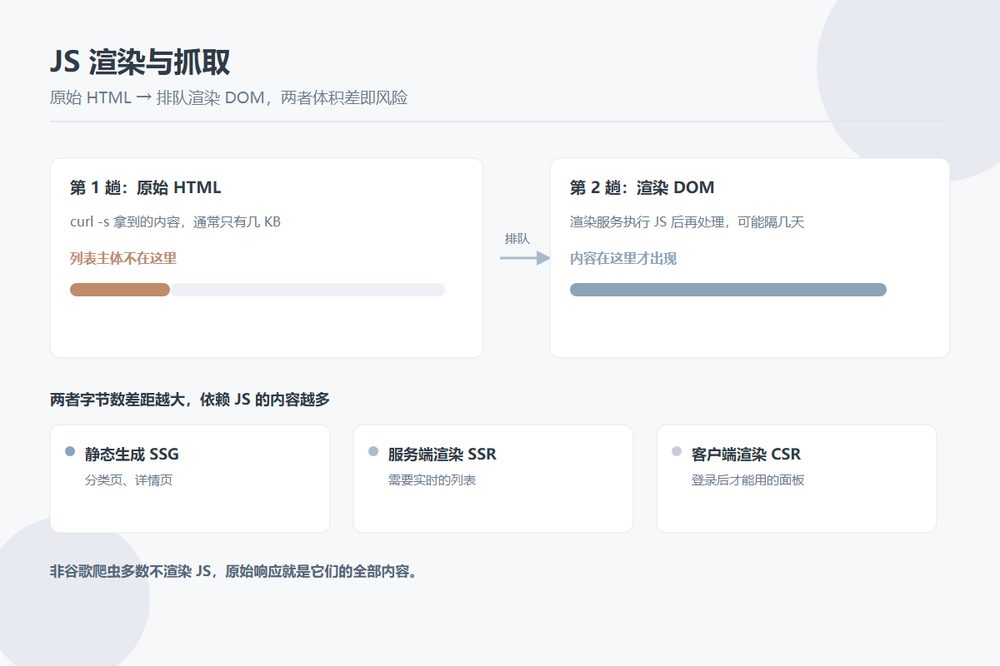
谷歌的做法是先抓原始 HTML 并初步处理,之后把需要执行 JS 的页面放进渲染队列,由渲染服务跑完后再处理一次。两趟之间可能间隔几天。这意味着哪怕最终能渲染出来,你的新内容也要多等一个环节。
在这个间隔里,页面如果被判断为质量不足,或者抓取量被消耗在别的地方,它可能连第二次机会都没有。
2024 年那次文档改动,说的是什么
谷歌在动态渲染的文档里写得很直白:这是一种权宜之计(workaround),不是长期方案,建议使用服务端渲染、静态渲染或 hydration。这份文档最后更新的时间是 2024 年 10 月。
顺带说明一下,动态渲染本身不在伪装页面(cloaking)的判定范围内,官方明确说过只要给爬虫和用户的内容是相似的就不算。真正的风险有两个:一是预渲染服务内容和线上版本不一致,二是缓存过期后爬虫看到的是旧内容。这两点让用户看到和爬虫看到的东西产生偏差,比渲染本身更容易出问题。
怎么测出自己的问题:一个命令就够
我最常用的土办法是对比字节数。在服务器上或者本地执行:
curl -s https://你的域名/某个列表页 | wc -c然后把同一个页面在浏览器里打开,右键另存为 HTML,看那个文件的大小。两个数字差距越大,说明依赖 JS 才能出现的内容越多。差距在几十 KB 以上,就值得认真处理了。
第二步是打开 Search Console 的网址检查,看“查看已抓取页面”里的 HTML 和截图。那里显示的就是爬虫实际拿到并处理过的版本。
渲染方式怎么选
| 方案 | 适合什么 | 要注意的地方 |
|---|---|---|
| 静态生成(SSG) | 分类页、条目详情页这类内容变动不频繁的页面 | 条目更新后要记得重新生成,别让静态版本停在旧数据上 |
| 服务端渲染(SSR) | 需要按条件实时的列表、筛选结果 | 服务器成本上来,要做好缓存 |
| 客户端渲染(CSR) | 登录后才能用的面板、后台 | 别把需要排名的页面放在这里 |
| 动态渲染(遗留) | 短期救火,比如老 SPA 暂时没法改 | 维护双套渲染管线,缓存过期风险高 |
别只盯着谷歌
很多人做技术选型的时候,脑子里只有谷歌一家。现实情况是:除了谷歌之外,多数爬虫基本不执行 JS,包括给各类 AI 产品供数据的抓取程序。它们就是发一个 HTTP 请求,拿到的响应是什么就算什么。
所以哪怕你的站点在谷歌那边一切正常,对这些来源来说,原始 HTML 里没有的内容就是不存在的。目录站尤其要意识到这点,因为现在很多 AI 产品的引用来源就是这些不渲染的爬虫。
判断标准很简单:核心内容必须出现在 HTTP 响应的 HTML 里。做不到这一点,CDN 再快、渲染脚本再优雅都没用。
给目录站的一条具体建议
把所有参与排名的页面(首页、分类页、条目页、标签页)做成服务端渲染或静态生成;筛选、折叠、切换视图这些交互可以继续用 JS,但不要让它成为内容唯一的出现途径。比如长假前的某个分类塞了两百个条目,可以分页处理,前面的部分直接写进 HTML。