
CDN 配错会拖累收录:谷歌那篇 Crawling December 讲的东西值得看完
 C
我一直觉得那篇博客是被低估的。它发布于 2024 年 12 月 24 日,主题是“CDN 与抓取”。里面没有玄妙的算法逻辑,讲的全是实操中真的会踩的配置。
图片来源:网络,版权归原作者所有,侵权请联系删除
好消息:套了 CDN,反而可以爬得更狠
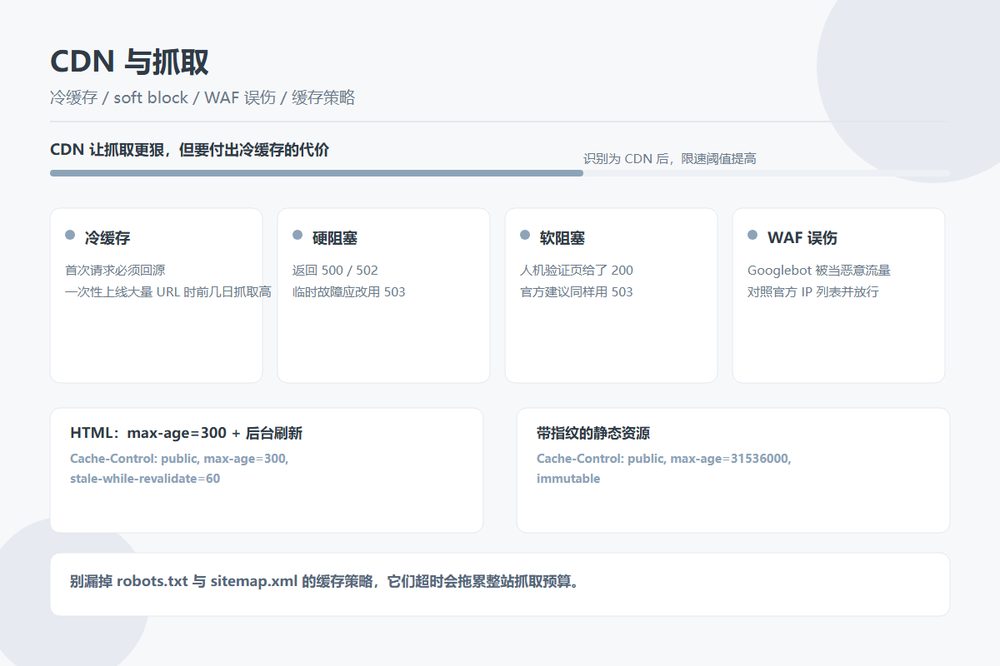
谷歌的抓取系统会通过响应来源的 IP 判断站点是否由 CDN 承载。一旦识别为 CDN 背后的站点,触发限速的阈值会被提高,也就是说允许更多并发请求。原因是它认为 CDN 能承受更大的流量。
对应的代价在另一段里讲清楚了:某条 URL 第一次被请求时,CDN 的缓存是冷的,内容还没任何节点里存着,源站仍然要把它真的吐一次,之后才有边缘节点的缓存。一次性上线大量 URL 的时候,开头几天会出现明显偏高的抓取活动——这是正常现象,提前有心理预期就好。
两类阻塞:软的和硬的
博客里把 CDN 引发的抓取障碍分成两类。
| 类型 | 表现 | 官方建议 |
|---|---|---|
| 硬阻塞 | 返回 500、502 这类服务器错误 | 临时性故障用 503 表示“暂时不可用” |
| 软阻塞 | 返回人机验证页、“你是人类吗”这类拦截页,却给了 200 状态码 | 同样应该用 503,否则内容可能掉出索引 |
软阻塞这一条特别值得记。WAF 或者 CC 防护在识别出“可疑流量”的时候,往往会给 Googlebot 一张验证页,状态码还是 200。搜索引擎看到的是一张没有内容的页面,而这种页面可能会被当成重复内容处理,进而更换索引,恢复起来很慢。
还有两种更隐蔽的情况
错误页返回 200。源站挂了但 CDN 返回了一页“稍后再试”的友好页面且状态码是 200,搜索引擎会以为这是一个正常页。这种情况比直接报错更麻烦。
WAF 按 IP 段拦截。把 Googlebot 识别成恶意流量直接拒绝。自查方法是对照官方公布的 Googlebot IP 列表核对被拦的 IP,并把它加入白名单。
缓存策略要分开写
HTML 和静态资源不该用同一套规则。
Cache-Control: public, max-age=300, stale-while-revalidate=60上面的写法给 HTML 五分钟的边缘缓存加后台刷新,适合内容更新需要尽快生效的列表页。带内容指纹的静态资源可以激进得多:
Cache-Control: public, max-age=31536000, immutable这里有个容易被忽略的点:robots.txt 和 sitemap.xml 的缓存策略也别忘了配。这两个文件是搜索引擎了解站点结构的入口,它们超时或返回异常,影响的是整站的抓取预算,性价比很高的一步。
怎么自查
- Search Console 的网址检查工具,看它从你的 CDN 到底拿到了什么
- CDN 日志按 Googlebot 的 UA 过滤,比对它看到的和浏览器看到的是否一致
- 看响应头里的 X-Cache 状态,确认命中的是哪一层
- 日志里回源请求占比异常高的话,检查是不是某些 Host 规则没配上
第二点要严肃对待。浏览器和 Googlebot 拿到不同版本的响应,本身就是伪装页面的风险信号,处理不好会引来人工处理措施。
CDN 能加速的是已经渲染好的 HTML。如果页面主体要靠浏览器里的 JS 异步生成,CDN 再快也只是把空壳更快地送到爬虫手上。
最后一句
把静态资源拆到独立主机名,有利于渲染服务并行取资源,但多一次连接也有开销。这个取舍不是必须做的,只有当你的资源量确实大、且渲染成为瓶颈时才值得。