
搜索结果里那段摘要你能控:nosnippet、max-snippet 与 AI 摘要时代的选择
 搜
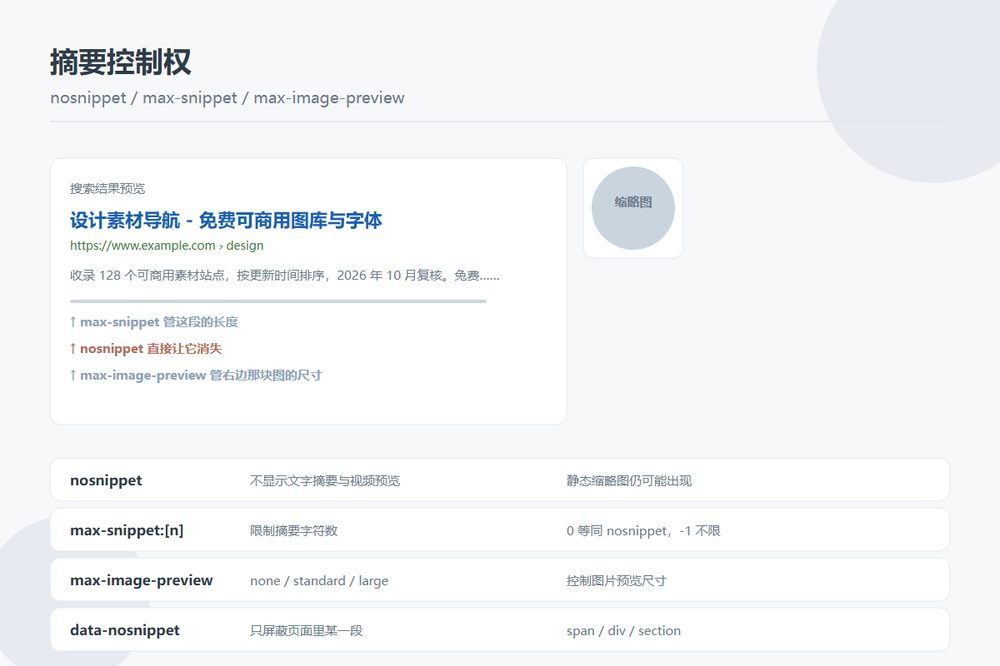
这段控制在里晨址里:一个 meta 标签和一个 HTTP 头。它管的是“内容怎么被展示”,而不是“能不能被索引”,这两件事经常被混为一谈。
图片来源:网络,版权归原作者所有,侵权请联系删除
指令放在哪里
最常用的是页面 head 里的 robots meta 标签:
<meta name="robots" content="max-snippet:160, max-image-preview:large">对于没有 head 的文件,比如 PDF、图片或者 feed,用 HTTP 响应头 X-Robots-Tag 发同样的规则:
X-Robots-Tag: noindex, nosnippet规则可以多个数值用英文逗号分隔,也可以写成多个 meta 标签。
四条值得记住的规则
| 规则 | 作用 | 备注 |
|---|---|---|
| nosnippet | 不展示文字摘要和视频预览 | 静态图片缩略图仍可能出现 |
| max-snippet:[数字] | 限制摘要字符数 | 0 等同 nosnippet,-1 表示不限制 |
| max-image-preview:[设置] | 控制图片预览尺寸 | 可选 none / standard / large |
| max-video-preview:[秒数] | 控制视频预览时长 | 0 表示最多用一张静态图 |
如果只要屏蔽页面里的某一段文字不想它出现在摘要里,用 data-nosnippet 这个 HTML 属性包住那段内容就行,位置可以在 span、div 或 section 上。比起整页 nosnippet,粒度细得多。
冲突时按更严的执行
同一个页面同时写了 max-snippet:50 和 nosnippet,最后生效的是 nosnippet。这条规则在执行时的一致性很高,不用猜。
一个前提条件,很多人栽在这
这些指令只有在爬虫能读到页面的时候才会生效。如果你在 robots.txt 里把这个 URL 屏蔽了,谷歌就没有抓取它,页面上的 noindex、nosnippet 一概看不到。这种情况下,这个 URL 仍然有可能因为外部链接的存在出现在搜索结果里——只不过连一串标题。
想让一个页面真正离开结果页,正确做法是允许抓取、在页面上写 noindex,而不是在 robots.txt 里禁止。
AI 摘要时代的取舍
文档对 nosnippet 的说明已经更新:它适用于所有搜索结果形式,包括网页搜索、Google 图片、Discover、AI 摘要和 AI 模式,而且会阻止内容被当作 AI 摘要和 AI 模式的直接输入来源。max-snippet 也会限制能被用作输入的内容量。
这里有一笔账要算。谷歌的 AI 功能文档说,页面要成为 AI 摘要或 AI 模式里的支撑链接,前提是它已被索引且摘要展示规则允许。加了 nosnippet,等于同时放弃了这两种露出。
不想被 AI 拿走内容,和想出现在 AI 引用的链接里,只能选一个。做决定之前先想清楚你要的是哪一个。
目录站怎么用这套东西
我的做法是不搞一刀切。条目详情页本来就是给搜索引擎看的,敞开着让它抓摘要;模板化的聚合页如果摘要一定会露出一整段重复话术,可以用 max-snippet 限制长度而不是全屏蔽;收费收录、付费推荐位这类页面按商业规则单独判断。
另外提醒一句:上线前顺手看一眼生产环境的 head。测试环境里为了不被收录加的 noindex、nosnippet,经常跟着模板一起发布到正式站点,谷歌专门提醒过这件事。
检查清单
- 抽出几个代表页面,看 head 里的 robots meta 实际输出了什么
- 确认那些 URL 没有被 robots.txt 屏蔽
- 用 site: 语法看一下实际展示的摘要长度是否符合预期
- 静态文件和 PDF 补上 X-Robots-Tag